智能数据可视化技术通常由四层能力组成:表达层的可视编码与图形语法,语义层的数据建模与指标口径,分析层的图表推荐、自然语言问数与智能归因,工程层的渲染性能与质量评估。企业评估一套方案时,可以按这四层逐项核对,判断哪些能力已经产品化,哪些仍停留在研究或演示阶段。
理解这条技术链路,能帮助业务负责人提出更具体的问题。同样叫智能可视化,有的产品只做到根据字段推荐图表,有的产品能接住连续追问并给出归因结果。两者的实现难度和使用条件差别很大。
一、智能数据可视化技术包含哪四层
先把技术分层,再谈具体功能,评估时不容易被宣传词带偏。四层的分工如下。
| 层级 | 主要任务 | 关键技术 |
|---|---|---|
| 表达层 | 把数据字段映射为读者能比较的图形 | 可视编码、图形语法、图表规范 |
| 语义层 | 统一字段含义、指标口径和业务术语 | 数据建模、指标管理、业务知识库 |
| 分析层 | 决定看什么图、为什么变化、下一步查什么 | 图表推荐、自然语言生成可视化、异常检测、归因分析 |
| 工程层 | 保证大数据量下稳定、流畅、可访问 | Canvas、SVG、WebGL、渐进渲染、可视化评估 |
数据接入、权限控制、任务调度等平台能力支撑可视化运行,但讨论智能数据可视化技术时,先看这四层更容易分清能力边界。研究文章里的自动生成能力,和产品中可以直接使用的功能,往往不在同一个成熟度上。 看到智能两个字,先问它解决的是表达、语义、分析还是工程问题。
二、可视编码与图形语法
图表能不能读懂,很大程度取决于可视编码是否匹配数据关系。位置、长度、角度、面积、颜色和形状都是常用编码通道。人的视觉判断对位置和长度的差异更敏感,对面积和颜色的细微差异较弱。
图形语法把一张图拆成数据、标记、编码和变换,再用声明式规则组合成图表。Vega-Lite 官方文档将其定义为面向交互图形的高级语法,用 JSON 描述多视图可视化。这样同一份数据可以快速切换柱状图、折线图和散点图,也能让系统在候选图表之间做比较。
选图要回到读者任务。比较不同渠道的转化率,柱状图通常比饼图容易读出差异;观察指标随时间的变化,折线图更合适;判断两个指标是否相关,散点图能保留分布信息。图形语法解决的是可描述和可组合,选图是否合适仍取决于分析任务。
三、数据建模与语义层
语义层解决字段和指标的含义问题。业务口中的付费率、活跃用户、留存率,在不同团队可能有不同算法。如果指标口径没有统一,自动生成的图表越漂亮,误解扩散得越快。
语义层通常包含三类内容。字段定义说明每个字段代表什么,指标口径说明分子、分母、统计周期和过滤条件,业务知识说明维度之间的层级关系。自然语言问数需要先识别问题里的对象、时间范围和比较方式,再把这些词映射到统一口径。统一指标口径是智能可视化能否被业务信任的前提。
以付费率为例,运营团队可能按活跃用户计算,财务团队可能按注册用户计算。系统如果不区分口径,同一句提问会得到两张不同的图。智能能力可以降低操作门槛,指标治理仍然要由企业自己完成。
四、图表推荐与自动可视化
图表推荐通常经过三步。第一步识别字段类型、取值分布和维度基数,第二步根据分析任务生成候选图表,第三步按有效性、可读性和多样性排序。学术界的 AutoVis、DeepEye、VizML 等系统都在这个方向上做过探索,有的用领域知识约束搜索空间,有的用真实图表案例训练推荐模型。
推荐系统能减少试错,但有几个限制需要说明。
- 用户的真实意图往往没有写在字段里。同一组销售数据,可以看总量、看结构、看趋势,也可以找异常。
- 推荐结果需要结合业务背景解释。没有标题、单位、时间范围和注释的图,放在汇报里仍然可能被误读。
- 研究论文中的推荐效果通常在特定数据集和任务上评测,不能直接当作企业场景的可用率。
可用的图表推荐应该允许用户修改字段、切换图表、追溯推荐理由。 只给一张图,不说明为什么推荐它,业务人员很难判断结果是否可信。
五、自然语言生成可视化
自然语言生成可视化,学术界常写作 NL2VIS,目标是把一句业务问题转换成数据查询、图表规格和可读结果。一条完整链路通常包括意图识别、数据查询、字段映射、图表生成和结果解释。
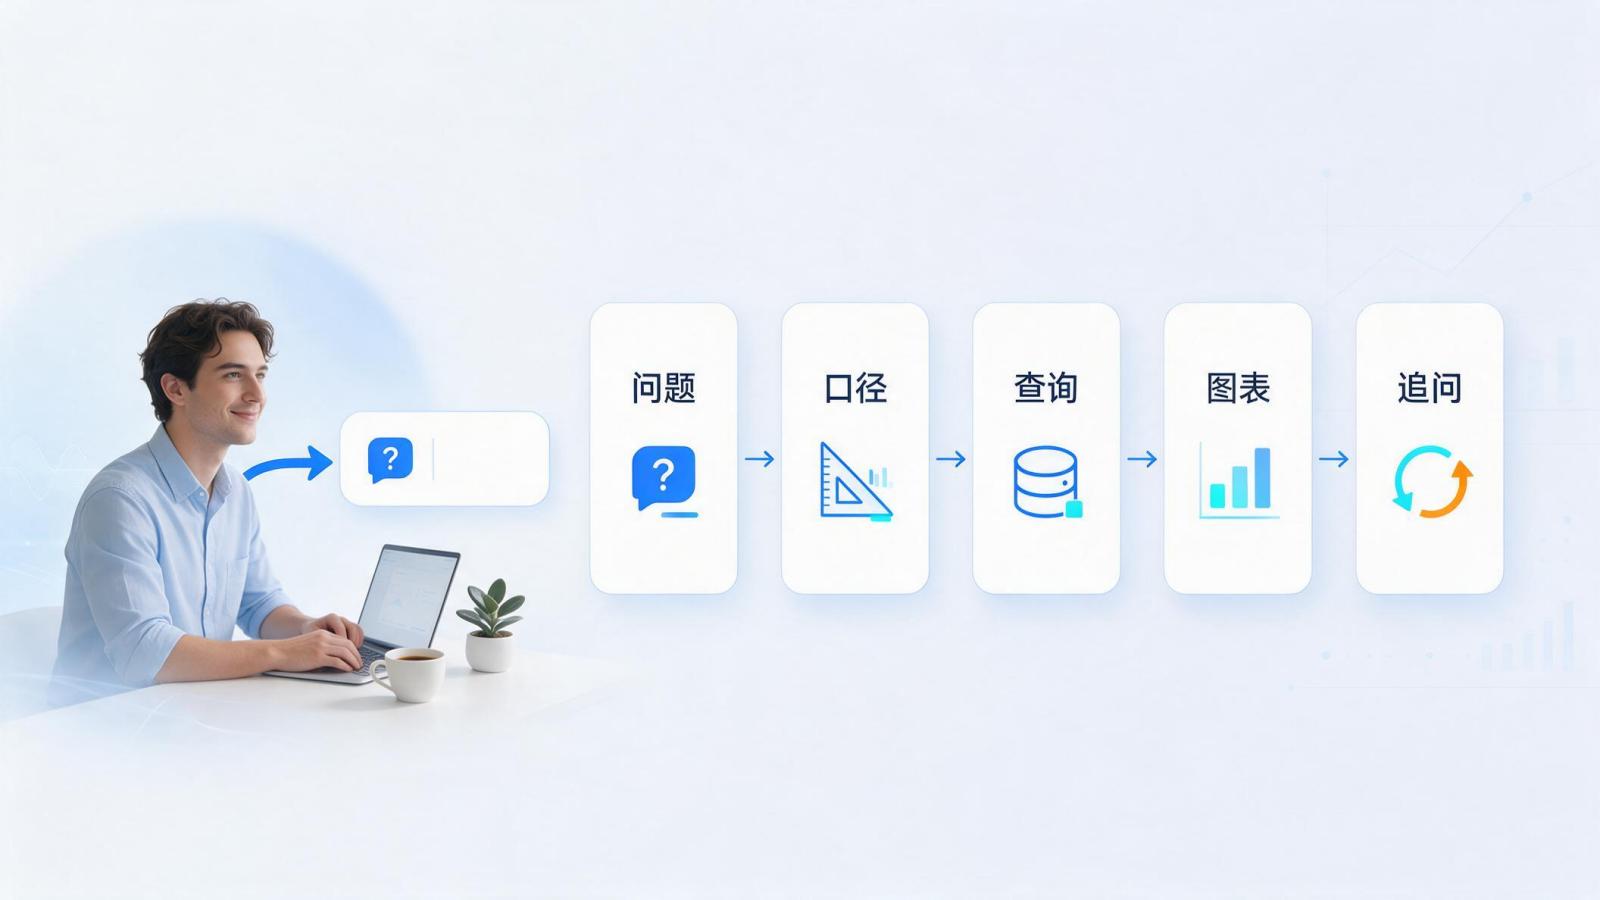
图 1 自然语言问数从问题理解到追问修正的五个环节。
传统方法依赖语义解析和规则映射,面对复杂问法容易丢失条件。大模型加入后,系统可以直接生成查询语句或图表代码,再根据执行结果迭代修正。中国图象图形学报 2026 年的一篇综述指出,大模型正在推动可视化从低层视觉编码走向语义驱动的表达,分析流程也从人工操作转向人、模型与知识协同。
这条链路仍有几个难点。
- 自然语言存在歧义。最近一周从哪天算起,新用户按注册还是首活定义,都需要系统追问或读取企业口径。
- 数据转换容易被忽略。用户问的是转化率,系统要先找到分子、分母和过滤条件,不能只画一个现成字段。
- 多轮追问需要保留上下文。上一轮筛选的渠道和时间范围,下一轮不应悄悄丢失。
Gartner 在 2025 年 6 月发布的预测中提到,到 2027 年,75% 的新分析内容会通过生成式 AI 结合业务上下文。这个方向值得关注,企业仍要用自己的问题集验证回答准确率和口径一致性。
对话式分析产品已经把这套能力产品化。ThinkingAI 数据分析 Agent 的公开页面列出了多轮追问、自动归因、智能可视化、实时监测与预警等能力,复杂查询平均 10 秒内返回结果,并支持自动匹配图表类型。想了解这类产品的完整分析链路,可以阅读 AI 数据分析完整指南。具体效果仍需结合企业数据质量和问题复杂度验证。
六、交互式可视分析
交互式可视分析把一次查图变成连续探索。常用交互包括筛选、缩放、刷选、联动、下钻和对比。多个视图联动时,用户在一个图里选中异常时间段,其他图会同步过滤,帮助定位相关维度。
交互设计的关键是让分析状态可见。用户需要知道当前看了哪些筛选条件、做过哪些下钻、能否回到上一步。多轮对话把交互入口从鼠标扩展到语言,系统仍需保留查询历史和条件,避免用户每问一次都从头描述。
一个常见的分析路径是,发现付费率下降,按渠道、版本、时段逐层下钻,再看新手引导的流失环节。交互技术负责让这条路径走得顺,智能分析负责提示从哪里开始查。 两者配合,才能把看图变成定位问题。
七、智能分析与归因
智能分析负责从图里找异常和线索。常用方法包括阈值与统计检验、时序异常检测、维度贡献分解和相关性分析。指标出现波动时,系统可以先判断波动是否超出正常范围,再拆解各维度对变化的贡献。
归因结果需要区分相关和因果。某个渠道的付费率下降,可能与渠道质量有关,也可能与版本改动、活动结束或统计口径变化有关。自动归因可以缩小排查范围,不能替代对版本、活动和外部事件的核对。 指标口径不一致时,归因还可能把口径差异当成业务变化。
企业可以把智能分析用在三类任务上。日常监控用于发现异常,专题分析用于拆解原因,复盘用于验证策略效果。三类任务对实时性、历史数据深度和解释能力的要求不同,选型时应分开评估。
八、渲染、性能与可视化评估
渲染技术决定图表在真实数据量下能不能用。SVG 适合元素较少、需要高清导出的场景,Canvas 在数据点较多时通常更流畅,WebGL 可以借助 GPU 处理大规模散点和三维图形。渐进渲染、数据抽样、服务端聚合和增量加载,都是常见的性能手段。
实时大屏还要考虑数据刷新频率、查询延迟和并发访问。图表数量多、维度切换频繁时,前端渲染压力会迅速上升。关于大屏的场景边界,可以参考智能数据可视化大屏的说明。
可视化评估覆盖准确性、可读性、可访问性和叙事效果。中国图象图形学报的综述把可视化基础理论、可视分析、可视化叙事与可视化评估列为四个研究方面,并提到大模型在图形质量评估和设计建议生成上的潜力。实际项目中,评估还应检查图表是否有清晰标题和单位、颜色对比是否足够、是否提供文字说明,以及导出和分享后信息是否完整。
九、企业怎样判断这些技术是否可用
企业评估智能数据可视化技术,可以从六个问题入手。
| 判断项 | 要问的问题 | 可用信号 |
|---|---|---|
| 语义一致性 | 同一指标在不同报表中是否同口径 | 能展示指标定义和计算逻辑 |
| 意图覆盖 | 常见业务问法能否被正确理解 | 能处理时间、筛选、对比和多条件组合 |
| 推荐可控性 | 推荐结果能否修改和解释 | 支持切换图表、调整字段、查看理由 |
| 交互上下文 | 多轮追问是否保留条件 | 能回看历史、恢复上一步、导出分析过程 |
| 性能 | 峰值数据量下响应是否稳定 | 大数据量有抽样、聚合或增量加载策略 |
| 评估与治理 | 结果能否审计、分享和访问 | 有权限控制、口径说明和可访问性支持 |
验证时不要只看演示数据。选十到二十个真实业务问题,覆盖趋势、对比、异常、归因和多轮追问,记录回答正确率、响应时间和人工修正次数。能在一个真实业务问题上给出可追溯结果,比功能清单更能说明技术是否可用。
如果企业还在判断是否需要独立的数据可视化平台,可以先看数据可视化平台的能力链路和适用边界,再决定采购、自建或沿用现有 BI。
常见问题
1. 智能数据可视化与普通 BI 图表有什么区别
普通 BI 图表主要解决数据展示和筛选,图表由人选择和配置。智能数据可视化在此基础上增加图表推荐、自然语言问数、异常检测和归因等能力,减少手工操作。区别体现在分析链路的自动化程度,不体现在图表数量。
2. 自然语言问数能替代 SQL 吗
常见查询可以交给自然语言问数,复杂的数据准备、性能优化和口径治理仍需要数据团队。自然语言接口适合业务人员快速取数和追问,SQL 仍适合精确控制查询逻辑和排查数据问题。
3. 自动推荐的图表可以直接用于汇报吗
可以直接作为初稿,正式汇报前仍需检查标题、单位、时间范围、口径和注释。推荐系统了解数据结构,不一定了解这次汇报要回答的业务问题。
4. 实时数据大屏需要哪些技术条件
需要稳定的数据采集与传输、低延迟查询、合适的渲染方式和并发支撑。数据量较大时,还要使用聚合、抽样或增量加载。刷新频率越高,对计算和网络的要求越高。
5. 中小企业需要自建这些技术吗
多数中小企业适合采购成熟产品,把精力放在指标治理和业务问题上。自建适合数据规模大、分析场景特殊或有强私有化要求的企业,前提是具备数据工程和算法团队。
6. 智能数据可视化会取代数据分析师吗
它会减少重复取数和基础图表制作,分析师可以把更多时间放在问题定义、口径设计和结论解释上。归因结果和自动生成的图表仍需要人判断业务含义。
参考资料
- 汪云海等. 大模型赋能的可视化与可视分析研究综述. 中国图象图形学报, 2026, 31(6): 2198-2221. DOI: 10.11834/jig.260046
- Vega-Lite 官方文档. Overview.
- Gartner. Gartner Predicts 75% of Analytics Content to Use GenAI for Enhanced Contextual Intelligence by 2027. 2025-06-18. https://www.gartner.com/en/newsroom/press-releases/2025-06-18-gartner-predicts-75-percent-of-analytics-content-to-use-genai-for-enhanced-contextual-intelligence-by-2027
- CFOtech. Gartner: Generative AI to power 75% of analytics by 2027. 2025-06-18.
- ThinkingAI. 数据分析 Agent 产品页. https://www.thinkingai.cn/agent/analysis/