统计中的数据质量的常见问题包括源头记录失真、统计误差、范围遗漏、发布延迟、指标不适用、口径不可比和数据间不协调。改进要对应具体成因:统一定义与统计范围,保留原始凭证和修改记录,把校验前移到采集加工环节,并为异常指定责任人、处理时限和复核机制。汇总结果正确,还需检查来源与过程是否可靠。
这篇文章讨论的统计数据,既包括政府统计调查中的报表数据,也包括企业内部的经营统计、上报报表和指标看板。
一、统计数据质量的九个判断维度
国家统计局在2021年版《国家统计质量保证框架》中,把统计质量分为真实性、准确性、完整性、及时性、适用性、经济性、可比性、协调性和可获得性九个方面。这个框架面向政府统计调查,企业统计也可以借用这套标准做自查。
| 维度 | 要回答的问题 | 常见失分点 |
|---|---|---|
| 真实性 | 源头数据是否符合调查对象实际情况,是否可溯源 | 代填代报、估算填报、缺少原始记录 |
| 准确性 | 误差是否控制在允许范围内 | 口径理解错误、计算方法错误、样本偏差 |
| 完整性 | 统计范围是否不重不漏,口径是否完整 | 漏报、重复上报、关键指标缺失 |
| 及时性 | 从调查到公布的时间是否满足使用需要 | 迟报、手工汇总拖延、发布日程不稳定 |
| 适用性 | 指标是否跟得上业务和政策需求 | 指标陈旧、口径与使用场景脱节 |
| 经济性 | 调查成本与数据价值是否匹配 | 重复调查、重复填报、数据来源未充分利用 |
| 可比性 | 不同时间、不同空间的数据是否可比 | 口径变更无说明、统计范围变化 |
| 协调性 | 总量与结构、指标与指标之间是否匹配 | 分项加总不等于总量、跨表数据矛盾 |
| 可获得性 | 用户能否方便获取并正确理解数据 | 只给结果不给口径、渠道单一、解读不足 |
九个维度不必平均用力,先选与当前决策更相关的三到五个。 比如月度经营分析更关心及时性、准确性和可比性,就可以先为这三项写出验收条件,再逐步扩展。
二、问题多出在四个环节
把质量问题放回统计生产流程,定位会更容易。国家统计局的框架把统计业务流程分为确定需求、调查设计、核准备案、任务部署、数据采集、数据处理、数据评估、数据公布与传播、统计分析、项目评估十个环节。实际工作中,问题多出现在采集、审核、汇总、发布四个位置。
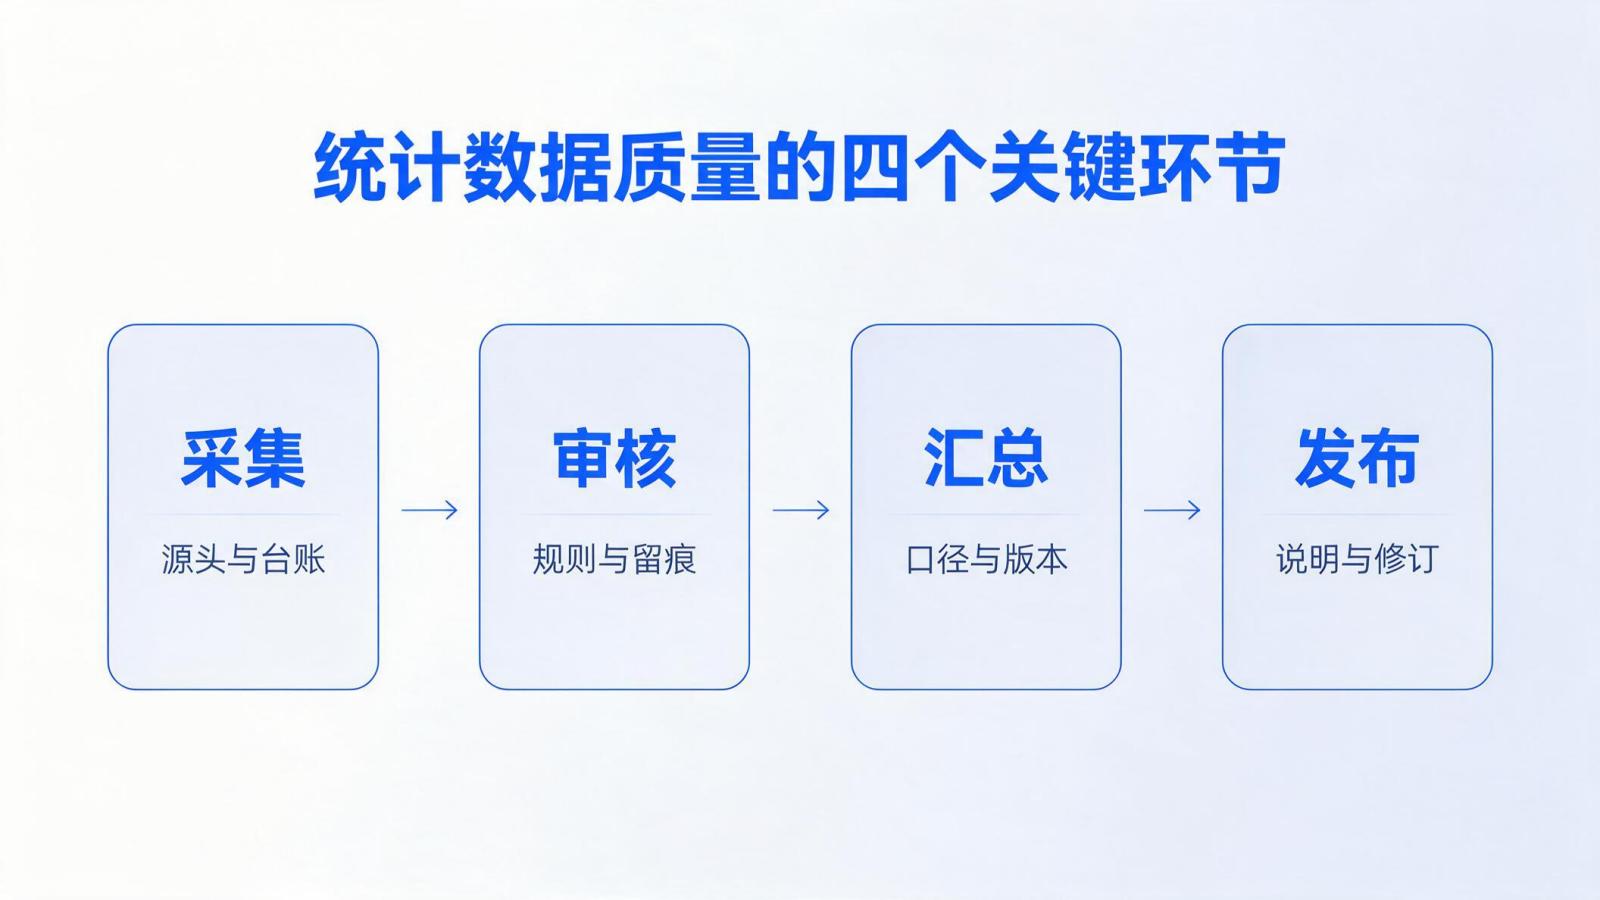
1. 采集环节,源头数据容易失真
- 指标理解不一致。统计范围、计算方法、计量单位各按各的理解填报。
- 调查对象配合不足。企业统计人员身兼数职,台账不完整,迟报、漏报时有发生。
- 采集方式不统一。手工报表、系统导出、接口采集并存,同一指标有多个来源。
- 原始记录缺失。数据经过多次转录,出现问题时无法追溯到填报人。
2. 审核环节,规则有,问题没拦住
- 只检查必填项和格式,缺少逻辑、阈值、跨期、跨表比对。
- 审核经验留在个人手里,没有固化成可复用的规则。
- 发现异常后直接修改结果,不回查源头,修改记录不完整。
- 审核责任不清,谁都能改,出了问题找不到责任人。
3. 汇总环节,口径和版本容易失控
- 指标口径变更后,报表、脚本、看板没有同步更新。
- 汇总层级和去重规则不一致,出现重复计算或漏算。
- 多份手工表格并行,最终没人说得清哪份是准的。
- 汇总结果与分项、历史数据、关联指标不匹配。
4. 发布环节,数据出去了,误解才开始
- 只给结果,不给统计范围、口径、来源和方法。
- 数据修订后不说明原因,用户拿新旧数据直接比较。
- 指标解释不足,业务按错误理解做判断。
- 缺少反馈渠道,用户发现的问题回不到生产环节。
如果时间有限,可以先按症状做一次快速定位。
- 同一指标两个部门数字不同,先比对指标定义、统计范围、取数时间和去重规则。
- 汇总数不等于分项之和,先查汇总层级、重复记录和舍入规则。
- 迟报集中出现,先查填报负担、任务部署和系统入口。
- 发布后争议多,先补口径说明、修订记录和指标解释。
三、成因可以分成四层
把原因全部归到基层统计人员,改进往往停在培训。更有效的做法是按制度与口径、流程与责任、人员与能力、系统与技术四层拆解,再为每层找可观察的信号。
1. 制度与口径
- 指标名称、业务含义、统计范围、计算公式、计量单位没有统一文本。
- 调查项目重复,指标交叉,基层重复填报。
- 口径变更没有版本、生效时间和历史对照。
2. 流程与责任
- 采集、审核、修改、发布的责任边界不清。
- 人员交接没有清单,历史口径和特殊情况随人走。
- 考核压力可能带来选择性统计、层层加码,干扰数据质量。
3. 人员与能力
- 不少基层统计岗位由财务或行政人员兼任,人员流动较快。
- 培训只讲表怎么填,不讲指标为什么这样定义。
- 对异常数据缺少判断经验,遇到问题习惯直接改数。
4. 系统与技术
- 多套系统并存,数据分散,取数靠手工导出。
- 缺少统一指标库、校验规则、数据血缘和版本管理。
- 系统能存数,不能解释数,问题定位依赖个人经验。
| 成因层 | 常见信号 | 先做的动作 |
|---|---|---|
| 制度与口径 | 同一指标多个版本,跨部门解释不同 | 建指标字典,写清范围、公式、单位、来源、责任人和生效时间 |
| 流程与责任 | 修改无记录,问题反复出现 | 明确采集、审核、修改、发布责任人,建立交接和留痕 |
| 人员与能力 | 培训后仍错,兼职岗位多 | 按岗位做短培训,把高频错误做成检查卡 |
| 系统与技术 | 多系统取数不一致,异常定位慢 | 统一取数入口,补校验规则、血缘和版本管理 |
四、改进按五步推进
改进顺序影响成本。先做能减少重复劳动和争议的基础工作,再上复杂工具,通常更容易持续。全流程控制可以参照数据质量防线的思路,从数据产生、流转、加工和使用四个位置设置控制点。
1. 把指标和口径写成可执行的定义
- 指标字典至少写清名称、业务含义、统计范围、计算公式、计量单位、数据来源、责任人和生效时间。
- 同一指标保留一个主定义,变更时新增版本,不覆盖历史。
- 把定义放到报表、接口、看板的同一处,减少口头解释和多份版本。
完成信号是不同部门按同一份定义取数,结果可以复现。
2. 控制源头采集
- 建名录库或样本框,明确调查对象和统计范围。
- 推广电子台账、系统直报和接口采集,减少手工转录。
- 对调查对象做短培训,给填表说明和常见错误示例。
- 保留原始记录、修改记录和说明,保证数据可溯源。
完成信号是随机抽取一笔数据,可以追到填报人、原始凭证和修改记录。
3. 把审核规则固化成规则库
- 完整性规则检查必填项、记录数、时间范围。
- 逻辑规则检查分项与总量、跨表、跨期、指标之间的关系。
- 合理性规则检查阈值、同比环比异常和分布异常。
- 一致性规则与财务、税务、社保、订单、库存等可比数据交叉核对。
- 异常处理按发现、回查、修正、留痕、复核的顺序走完闭环。
完成信号是同类错误重复出现的次数下降,异常处理有时限、有记录。
4. 固定汇总和发布
- 汇总脚本和模板版本化,避免个人本地表成为唯一版本。
- 发布前做总量、结构、历史、跨部门四项核对。
- 发布时同时给出口径、范围、来源、方法和修订说明。
- 数据修订保留旧版本,标明修订原因和影响范围。
完成信号是同一指标在不同报表、看板、发布稿中保持一致,修订可以追溯。
5. 评估、复盘和回滚
- 用抽查和核查验证源头数据,计算机自动核查、相关数据对比、综合校验可以组合使用。
- 对总量较大、波动异常的调查对象做重点核查。
- 口径或规则变更前保留旧版本,出现异常可以恢复并说明。
- 把发现的问题反馈到指标定义和审核规则,形成下一轮改进。
国家统计局在统计质量管理体系中介绍,2023年印发的试行版《统计源头数据质量核查办法》明确统计机构主要负责人、专业负责人、统计人员和调查对象各自的责任,并综合采用计算机程序自动核查、相关数据对比核查、综合数据校验核查等方式,对新增、变动、总量较大、波动异常的调查对象重点核查。
完成信号是问题能回到具体环节,改进措施有责任人和完成时间。
五、用指标验证改进效果
改进是否有效,不能只看有没有开会、有没有培训。可以选一组结果指标和过程指标,按季度或按月跟踪。
- 结果指标包括差错率、迟报率、漏报率、重复填报数量、数据修订次数。
- 过程指标包括异常发现时间、异常闭环时长、规则命中率、口径一致率。
- 使用指标包括用户查询响应时间、口径说明覆盖率、数据被误读的次数。
验证方法可以按三个层次做。第一层,同一指标在多张报表、多个系统之间对账。第二层,抽取一定数量的调查对象做现场或电话复核。第三层,发布后收集用户问题,检查是数据错误还是解释不足。更完整的评估流程可以参考数据质量评估。
如果只做一件事,先选一个高频指标做端到端试点。从定义、采集、审核、汇总到发布,把每个环节的验收条件写清楚,再复制到其他指标。
六、技术工具能帮什么,边界在哪里
技术工具可以降低重复劳动,也能让问题更早暴露。常见作用包括统一指标口径、自动校验、异常预警、血缘追溯、版本管理和问题闭环。
工具也有边界。责任体系、审核流程、调查对象配合和业务判断,仍要由组织自己建立。系统上线后如果没有人维护规则、处理异常,质量问题会换一种形式出现。
在指标定义和知识治理层面,ThinkingAI 的企业级知识库以 SSOT 保证同一概念全系统只有一处定义,通过 ChangeSet 记录变更、支持对比和回滚。这类机制适合维护统计指标字典、口径版本和发布说明。Agentic Engine 支持私有化部署,适合对数据主权有要求的企业。ThinkingAI 在数据智能领域服务全球超 1500 家企业,接入产品超 8000 款。
如果企业正在评估用 Agent 做质量排查,可以先读数据质量Agent,再判断自己的规则、元数据和责任体系是否具备试点条件。
常见问题解答
统计数据质量不高的表现有哪些?
常见表现包括源头数据失真、同一指标口径不一致、漏报重报、审核流于形式、汇总数与分项数矛盾、发布时缺少口径说明。表现通常跨环节出现,定位时可以先从采集和审核两处查起。
统计数据质量不高的原因有哪些?
原因可以分为制度与口径、流程与责任、人员与能力、系统与技术四层。基层力量薄弱、统计人员兼职多是常见原因之一,只做培训往往不够,还要补口径、责任、规则和工具。
统计数据质量存在的问题及建议怎么写?
可以按现象、影响、原因、措施、验证五段来写。现象要可观察,影响要说明用在哪个决策上,原因要与现象对应,措施写清责任人、时限和完成信号。建议部分少写加强重视,多写具体动作。
统计数据质量管控方面存在不足,先改什么?
先选一个高频指标做指标字典和源头台账,再把审核规则固化,随后统一发布口径。如果迟报集中出现,先查任务部署和填报负担,再考虑增加系统功能。
统一指标口径就能解决统计数据质量问题吗?
口径统一解决一致性和可比性的一部分。源头控制、审核、发布和验证仍要跟上。口径是基础,不能替代全流程管理。