- 1 天:玩家行为分析耗时
- 3 天:从发现流失问题到确定策划
运营一款游戏,比数字变化更难的,往往是接下来的那个问题。
内容参与率下降了,是哪些用户发生了变化?付费用户流失了,该从哪里查起?改进方案上线后,玩家的实际游戏行为真的变了吗?要回答这些问题,需要查看数据、检验各种可能的解释,再决定下一步行动。团队小,并不意味着可以省掉这个过程。Underdox 用 6 个人完成这件事。他们用约 6 个月开发出 4X 策略游戏《Polaris: Crown Legacy》,并在东南亚自主运营,目前还在开发下一款 MMORPG。
他们选择的方式,不是给每个人多配一个 AI 工具,而是在汇集于 ThinkingAI 的数据之上接入按角色分工的 Agent,让提问和分析真正转化为运营决策。
摆脱“一个问题牵动多个部门”的做法
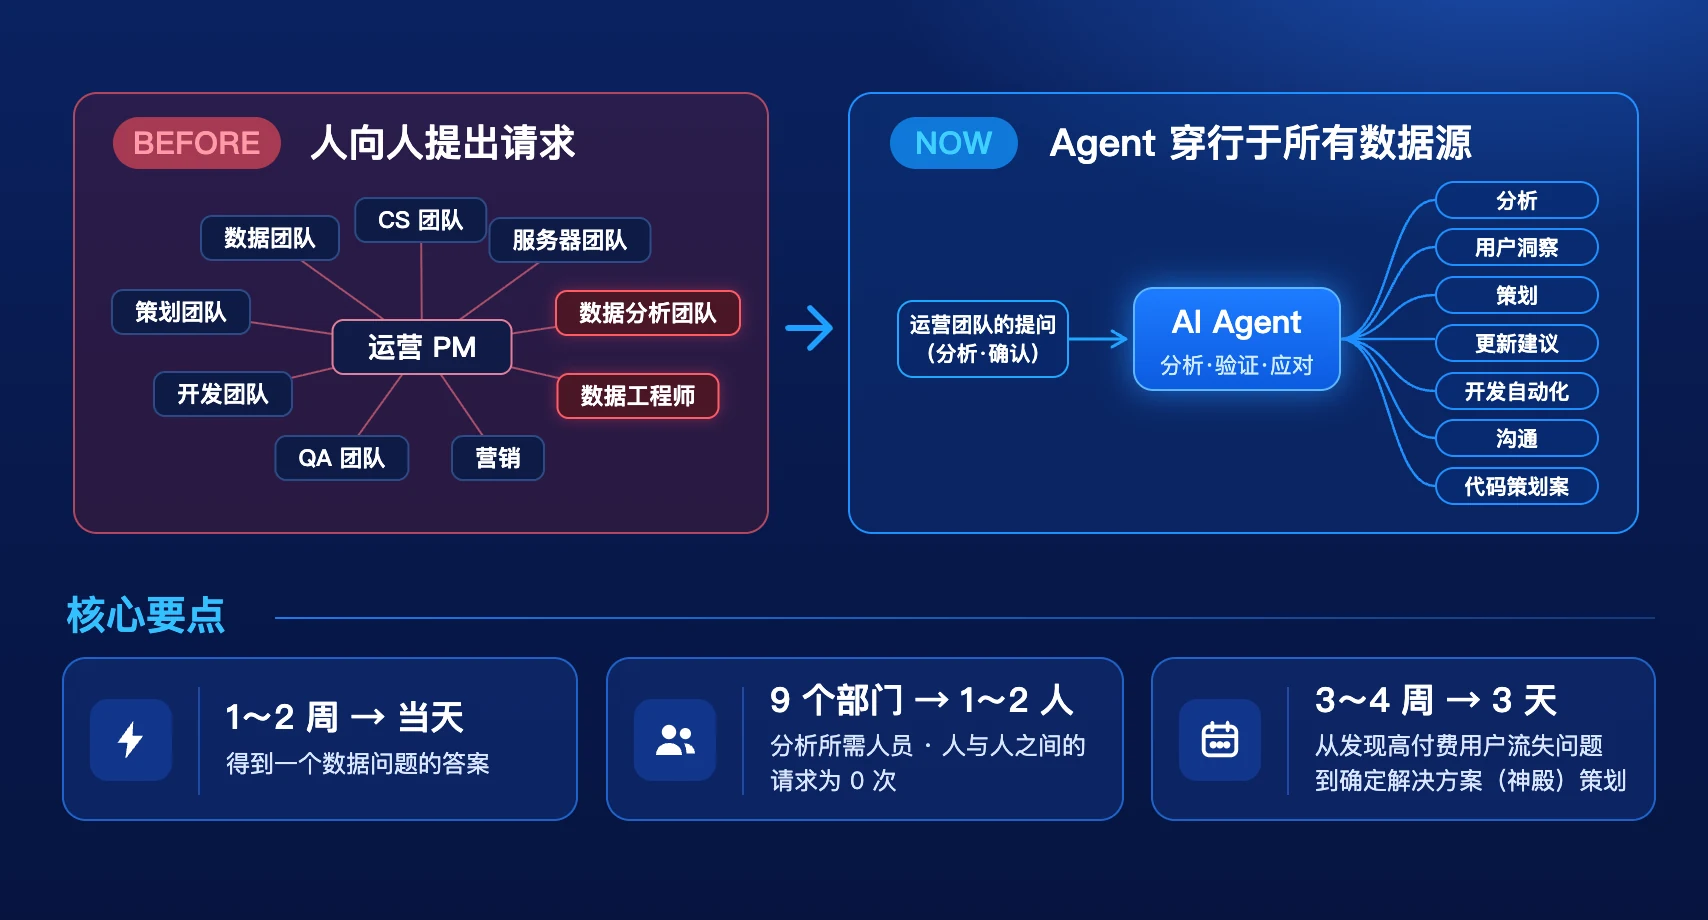
在大型游戏公司,要回答“这个用户为什么流失?”,需要多位负责人联动:分析团队去找数据,工程师确认所需日志;要排查付费或登录问题,还得请其他部门帮忙;分析结果出来后,还要再传达给策划和开发。据 Underdox 介绍,原先的工作方式下,一个数据问题要在 9 个部门之间来回流转,得到答案需要 1~2 周。
现在,同类问题由 1~2 个人当天就能得到答案。人不再向各部门传递请求,而是由 Agent 查询所需的数据源并继续分析。人的角色也变了:比起请求和汇总数据,更专注于决定要确认什么、判断结果。
先别看整体平均值,先缩小到“哪里变了”
《Polaris》每周都会更新多个小游戏。Underdox 想确认这类内容是否值得持续投入,于是查看了参与率。起初,参与率似乎因国家、广告渠道和广告素材而异,这很容易让人怀疑:不同的流量来源,带来的是不同倾向的用户。
但换一个比较口径,解读就不一样了。
不再以全部登录用户为基数,而是改以“达到小游戏开放等级的用户”为基准重新查看,各国之间的参与率差距大幅缩小。原来是各国尚未达到该等级的新用户占比不同。这一发现也改变了后续的判断:与其减少小游戏的制作,或按国家区别运营,不如打磨前期的进度设计,让更多用户能够接触到这部分内容。重要的不只是把数据切得更细,而是区分被整体平均值掩盖的用户进度状态,并判断究竟该比较什么。
从一个用户的流失,找到待验证的假设和待改进的对象
另一项分析从一个简短的问题开始。
“高付费用户 A,为什么流失了?”
用户 A 注册后很快升到服务器前列,但在一场守城战中被攻击后,一天之内损失了 46% 的战斗力。此后登录频率逐渐降低,最终离开了游戏。仅凭这条记录,无法断定流失的原因,因为战斗之后也可能发生了别的问题。Underdox 综合查看付费、战斗、联盟、登录等数据,检验了一个假设:“需要重新培养损失的兵力,这种负担可能与流失有关”。验证 Agent 还确认了是否存在支付错误等其他解释。
接着,他们把问题又拓宽了一步。
“同样方式被攻击的其他用户,是不是也类似地离开了?”
把一个人的经历,扩展到遭受类似损失的用户群体后,出现了这样的模式:在大规模兵力损失之后,伴随着重建的负担,用户流失。这样就能更具体地看到,应该改善谁、改善什么情况。
分析的下一步不是报告,而是内容策划
Underdox 选择用游戏设计来减轻重建的负担。解决方案是“神殿”内容:阵亡的士兵,有一部分会随着时间回来。这是要把失败从“失去一切的经历”,变成“随时间可以恢复的经历”。从发现问题到敲定神殿的策划方案,用了 3 天。实现和上线是在这之后另行进行的。Underdox 表示,更新后,以同样模式被攻击的用户,在重建兵力的同时留在了游戏中。这是一个把分析得出的判断落实为实际内容变更,并在之后观察用户游戏行为的案例。
不过,“用户留下来了”这一观察,与证明更新的效果,需要区分开。该资料中不包含对照组或 A/B 实验结果。要更明确地确认变化是否源于改进方案,条件允许的话,需要设置对照组来验证。尽管如此,这个案例展现的变化是明确的。重要的不只是分析变快了,而是发现一个用户的流失、确认是否为重复出现的问题、再关联到内容改进,这整个过程连成了一个完整的流程。
比 Agent 更早需要的:准确的数据和分析经验
Underdox 的案例里有一点不能忽视:这个变化并不是接入一个 Agent 就能实现的。付费、战斗、联盟、登录等所需的数据必须准确地汇集在一起,也需要有关“按什么标准分析、如何确认其他可能性”的经验。
“Agent 之所以能干活,是因为数据已经准确地积累在同一个地方。”—— Underdox 联合创始人 강민석
ThinkingAI 提供把行为数据准确汇集到一处的基础,以及 Agent 可以调用的用户分析技能。Underdox 在此之上,自行搭建了按角色分工的 Agent、知识库和开发流水线,还把执行分析的 Agent 和验证结论的 Agent 分开。分析以只读方式进行,开发 Agent 产出的改动以 PR 提交,由人审核批准。即使 Agent 协助分析和实现,决定改什么、最终批准的责任仍然留给人。
让下一次分析从上一次的基础出发
Underdox 没有丢弃分析中发现的失误。例如:不把用户自行取消的支付统计为错误,区分使用同一设备的多个账号,对齐服务器与客户端的时间差后再比较,他们把这些验证标准留了下来。这样积累的“陷阱清单”有 161 条,可复用的流程和已保存的查询有 66 个。类似问题再次出现时,可以沿用此前的分析流程和判断标准,降低下一位负责人掉进同一个坑,或把同样的问题从头再解一遍的可能。Underdox 的案例中积累下来的,不只是报告,而是团队对“接下来该确认什么”的知识。
我们的团队能连接到什么程度?
不必只把 Underdox 的案例看作“靠 AI,少数人做了更多事”的故事。更重要的变化是:
- 超越整体平均值,缩小到出现变化的用户和情境。
- 把可能的解释设为假设,并检验其他可能性。
- 把分析结果落实为具体的内容改进方案。
- 把发现的陷阱和分析流程,沉淀为下次可用的知识。
当然,不能断言所有团队都能以同样的形式实现。实际能连接到什么范围,取决于持有的数据、对接环境,以及执行和上线的功能与权限。Underdox 搭建的 Agent 和开发流程,也是团队在 ThinkingAI 的数据和分析基础之上自行设计的部分。
我们的团队需要确认的,不只是“能不能用 Agent”。还需要一起考察:有哪些数据可以回答什么问题,怎样把答案转化为行动,以及如何验证并留存结果。